ビッグ エンディアン リトル エンディアンの選択は、低レイヤーのソフトウェア開発からネットワーク通信の設計に至るまで、システム構築の基盤を左右する重要な概念だ。コンピュータが多バイトのデータをメモリ上に配置する際、上位バイトと下位バイトのどちらを若いアドレスに置くかという「バイトオーダー(バイト順序)」の違いは、見た目の単純さとは裏腹に、過去数十年間にわたり無数のバグや通信エラーを引き起こしてきた。
現在のようにクラウドサービスとエッジデバイスが複雑に連携する環境下では、異なるハードウェア間でのデータやり取りが日常化している。エンジニアがビッグ エンディアン リトル エンディアンの挙動を深く理解しないまま生のバイナリデータを送信すると、値の逆転やメモリ破壊といった深刻な障害を招くことになりかねない。
ビッグエンディアンとリトルエンディアンの違いを解説:CPUのデータ格納順と転送ミス防止の必須知識
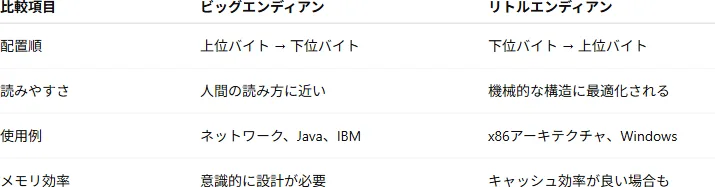
バイトオーダーの核心は、複数バイトで構成される数値データがメモリの連続したアドレスにどのように保存されるかという順序にある。例えば、32ビットの16進数数値「0x12345678」を例に挙げてみよう。このデータは「12」「34」「56」「78」という4つのバイトで構築されている。
ビッグエンディアン(Big-Endian)のシステムでは、最上位バイト(MSB: Most Significant Byte)である「12」を最も若いメモリ residency アドレス(例: 0x00)に配置する。人間の感覚的な数字の読み方と同じく、左から順に「12, 34, 56, 78」とメモリへ格納される形式だ。構造が直感的であり、メモリダンプを直接解読しやすい点が大きなメリットとなる。
一方のリトルエンディアン(Little-Endian)では、最下位バイト(LSB: Least Significant Byte)である「78」を若いアドレス(0x00)へ格納し、「78, 56, 34, 12」の順で保存する。一見するとデータが逆転しているように見えるが、CPU回路レベルでは下位桁の計算から着手できるため、加算処理などのハードウェア実装を簡略化・高速化しやすい利点を持つ。
ネットワーク通信において転送ミスを防ぐためには、送り手と受け手のアドレス配置順序を一致させることが不可欠だ。リトルエンディアンの送信側が構造体のバイナリ表現をそのままネットワークに流し、ビッグエンディアンの受信側がそのまま読み取れば、数値はまったく別の値として処理されてしまう。このミスマッチを防止するため、データの送受信時にはバイトオーダーの変換処理を明示的に挟むのが鉄則とされている。
風刺小説からコンピュータへ:ダニー・コーエンが名付けた「宗教戦争」の歴史
「エンディアン」という奇妙な用語のルーツは、技術用語ではなく18世紀の風刺文学にある。ジョナサン・スウィフトの小説『ガリバー旅行記』に登場する小人国リリパットでは、ゆで卵を大きい方(Big End)から割るか、小さい方(Little End)から割るかを巡って不毛な内戦が繰り広げられていた。
この滑稽な対立を計算機のデータ構造論争になぞらえたのが、計算機科学者のダニー・コーエンだ。彼は1980年、インターネットの前身であるARPANETの実験文書(IEN 137)として「On Holy Wars and a Plea for Peace(聖戦と平和の祈りについて)」と題した論文を発表した。
当時、CPUメーカーごとにバイトの格納順序が乱立し、互換性不在の議論が続いていた。コーエンはこの無意味とも思える仕様の違いを小説の「卵の割り方」になぞらえ、論争に終止符を打つべく「ビッグエンディアン」「リトルエンディアン」という言葉を定義した。この比喩がそのまま業界に定着し、現代のコンピュータアーキテクチャにおける基本用語として受け継がれている。
x86とARMアーキテクチャの対立:インテル支配からバイエンディアンの時代へ
バイトオーダーの歴史は、そのままプロセッサ業界の覇権争いの歴史でもある。かつてPC市場を席巻したインテルの「x86」プロセッサは、徹底してリトルエンディアンを採用していた。これに対し、メインフレームやハイエンドワークステーション(IBMやモトローラ、旧Sun MicrosystemsのSPARCなど)はビッグエンディアンを標準としていた。
インテルによるx86アーキテクチャの急速な普及に伴い、個人用PCや一般的なサーバー市場ではリトルエンディアンが圧倒的なシェアを獲得するに至った。その結果、「メモリ上でのデータ読みやすさ」よりも「x86との親和性」が重視される時代が長く続いた。
しかし、スマートフォンやIoT機器、さらにはデータセンター用省電力サーバーの主役に踊り出たARMアーキテクチャの台頭が、状況をさらに柔軟なものへと変化させた。現代のARMプロセッサの多くは「バイエンディアン(Bi-Endian)」仕様を備えており、レジスタの設定ひとつでビッグエンディアンとリトルエンディアンの双方を切り替えて動作させることが可能だ。もっとも、実際のOS運用においてはx86とのエコシステム共通化を図るため、大半のARMデバイスがリトルエンディアンモードで稼働している。
ネットワークバイトオーダーの標準化:TCP/IPプロトコルとIETFの決断
ハードウェアごとのバイト順序の乱立に対抗し、インターネット通信の共通言語として規格化を推進したのがIETF(Internet Engineering Task Force)だ。ネットワークを介して異種暗号や異種マシンがデータを交換する際、送信順序のルールが存在しなければ通信は成立しない。
IETFは通信プロトコルの標準規格として、ネットワーク上を流れるマルチバイトデータのパケットヘッダ(IPアドレスやポート番号など)を「ビッグエンディアン」に統一することを定めた。これが「ネットワークバイトオーダー」と呼ばれる概念である。
TCP/IPプロトコルスタックを実装する際、開発者はホストマシンのバイト順(ホストバイトオーダー)からネットワークバイトオーダーへの変換を行う必要がある。C言語などのシステムプログラミングにおいて用いられる htons()(Host to Network Short)や htonl() などのAPI関数は、まさにこのアーキテクチャ間の差分を安全に吸収するために用意された伝統的なツールだ。
Linuxシステムと組込みシステム業界における現代のエンディアン問題
エンディアンの問題は過去の遺物ではなく、現代の高度に分散されたシステム環境においてもなお現役の課題である。オープンソースの標準OSであるLinuxは、x86_64、AArch64、RISC-V、POWER、s390xなど多種多様なプロセッサ上で動作するが、内部での型変換ミスによるバグの芽は常に潜んでいる。
とりわけ過酷な検証が求められるのが組込みシステム業界だ。自動車のECU(電子制御ユニット)、産業用ロボット、医療機器などの分野では、旧来のビッグエンディアン基板から収集されたセンサーデータと、最新のリトルエンディアン向けSoC(System on Chip)が同一ネットワーク上で混在するケースが少なくない。
CANバスやModbusといった産業用シリアル通信プロトコルにおいては、仕様書ごとにデータ順序の定義が異なる。これらを統合するプログラマーがバイトオーダーの変換を怠ると、センサーの測定値が異常な巨大数値に化け、システム全体が停止する事態すら引き起こされる。
メモリダンプの罠を回避する:開発現場で実践すべきデバッグ手法
バグの発生を未然に防ぎ、バイト順序に依存しない堅牢なコードを記述するためには、開発時のベストプラクティスを徹底する必要がある。最も有効な対策は、構造体のバイナリ表現をそのままソケット通信やファイルストレージへ書き出す「生ダンプ」を避けることだ。
現代のシステム開発では、Google Protocol BuffersやFlatBuffers、あるいはJSONやCBORといったシリアライズフォーマットが標準的に用いられている。これらのライブラリは内部でバイト順序の違いを完全に抽象化するため、開発者がエンディアンを意識せず安全にデータをやり取りできる環境を提供する。
また、CやC++で低レイヤーコードを書く場合は、ビットシフト演算(<< や >>)を活用したエンディアンフリーなデコード処理を記述することが推奨される。明示的なシフト演算はコンパイラの最適化によって効率的なマシン語へと変換されるため、性能を損なうことなく高いポータビリティを実現できる。過酷な開発現場ほど、こうした「基礎への回帰」がシステム障害を防ぐ最強の盾となる。